登录社区云,与社区用户共同成长
邀请您加入社区
笔者这几天需要使用Google的mediapipe框架进行自定义的数据训练,值得注意到的是Google家的这个方便的自定义训练只支持在Linux下完成。具体原因可以参考到也即是google.colab库需要的环境就是Unix系的OS。。。所以没办法(耸肩),只好在WSL上完成mediapipe应用框架的搭建,刚好笔者准备尝鲜。
具体细节大家自己去百度和看各博客,这里给出一个简要的指南:1、cuda 安装11.1 对应 cudnn安装cudnn-v8.0.42、nv驱动只能用 最新的456.433、python 可以使用3.7 3.8均可可用anaconda安装4、tensorflow 安装最新的nightly版本 https://pypi.org/project/tf-nightly-cpu/ (2.4.0 dev版本)
反复用两台计算机安装测试,发现同样的流程,如果使用cuda9.0将会提示错误,所以无奈只能换作cuda8.0版本,这样子就解决了问题,但是具体哪个环节的配置出现问题,还未找到原因。有知道的朋友可以留言探讨。至于安装的版本,使用的是.run文件,后来换作了.deb格式的cuda8.0
Could not load dynamic library ‘cudart64_100.dll’; dlerror: cudart64_100.dll not found;cublas6_100.dll not found;cufft64_100.dll not found;curand64_100.dll not found;cusolver64_100.dll not found;cuspa
前言运行之前运行没有报错过的基于tf1.13.1的程序,报错:CUDA driver version is insufficient for CUDA runtime version网上搜索了一下,是因为cuda的驱动版本与cuda的运行版本不匹配导致的。后面询问,原来是组里其他人在全局进行了操作,导致此项问题出现。关于cuda驱动版本与运行版本在命令行中输入:nvidia-smi,在右上角会出现
可以看到需要对应安装cudatoolkit==9.0, 我们在通过命令: “conda search cudatoolkit"来看一下是否有此cudatoolkit的安装包,输入"conda search cudatoolkit”安装成功cudatoolkit之后,需要再安装对应版本的cudnn, 于是通过conda search cudnn查看一下,发现也是有可以安装的版本。发现是有这个cuda
在anaconda3的目录下搜索cudart64_100.dll,把它的路径加入到系统环境变量PATH中,重启kernel,再次运行代码,就没有报错了。参考链接:https://www.lagou.com/lgeduarticle/74076.html
最近一年多时间里,陆续安装了几块4090显卡。在不同的机器上下载CUDA驱动时,有时选择了11.8版本,大多数时候选择的是12.x的版本。平时开发大部分时间使用pytorch,偶而使用tensorflow。每次安装Tensorflow时都需要折腾很长时间。出现的问题要不是上面找不到某些cudart64_110.dll的错误,要不其它的一些问题。在Win11和WSL2上都存在问题。
联想拯救者Y7000P显卡:英伟达4060 系统:Win11。
面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新**
利用vscode与ssh插件连接服务器我当时看的这篇知乎,讲得很详细https://zhuanlan.zhihu.com/p/412736012但是注意,在配置config文件时,IdentityFile这个属性并不是必须的,这是为了每次登录免输入密码搞的公钥私钥。但一般情况下如果服务器不是自己的应该配置不了这个东西利用命令行下载+安装Anaconda3参考这篇简短的博客,注意选择好自己要下载的版
python-annaconda
这个方法可以避免安装多个cuda的切换问题,直接在每个虚拟环境中安装自己需要的cuda版本,相比较tensorflow官方推荐的docker的安装方法,可以达到相同的效果,但是实践起来更简单,总之推荐大家以后在虚拟环境下安装所需要的cuda和cudnn。
各种版本:Cuda: 12.2。
首先十分感谢我的老师对我的支持,终于申请到了电脑,现在终于可以在linux系统下载配置tensorflow-GPU加速器了,对于新手说安装过程也是十分’感动’,掉坑无数,希望本文可以给大家带来帮助。步骤一:安装Nvidia显卡驱动步骤二:下载并安装cuda8.0步骤三:安装GPU版tensorflow步骤四:安装atom及其插件步骤五:测试程序步骤一 :安装Nvidia显卡...
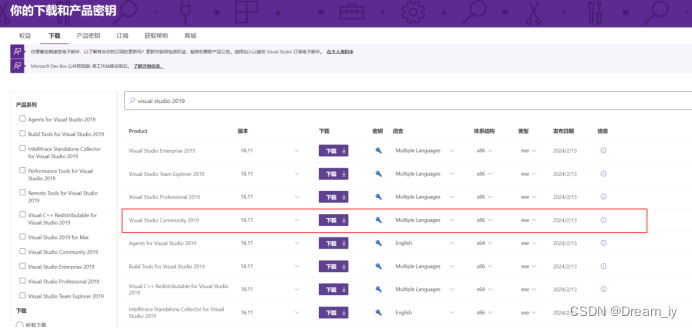
深度学习第一步 利用CUDA进行GPU加速 Win10/Win11+vs2019+cuda11.2+cuDNN8.1安装配置教程
在Anaconda的虚拟环境上安装cuda、pytorch、opencv以及tensorflow 以及相关报错。
论文代码用的环境不同需要配置不同版本的pytorch、tensorflow、cuda、cudnn。方法:1、win10安装高版本(最好是最新的)的cuda2、conda创建的虚环境中根据需要安装cuda、cudnn版本,即 conda install cudatoolkit=版本号,cudnn对应版本会跟随cudatoolkit一起安装。注意:1、cudatoolkit版本一定要低于本机安装的cu
一个详细的CUDA和cuDNN安装教程:caffe安装系列——安装cuda和cudnn
tensorflow,keras,cuda,cudnn安装没问题但就是无法使用GPU,一度让我怀疑人生。
• tensorflow 与 cuda版本对照表• cudnn清华源查看版本错误方法:nvidia-smi可驱动的最高版本为11.5下载的cuda的版本应低于11.5正确方法:nvcc --version检查它们是否安装成功。1 .首先 win+R 进入cmd,在命令行输入nvcc -V,如下图所示,则表示cuda已经安装成功。
win10 +Tensorflow-gpu环境搭建(cuda10.1+python3.8+tensorflow2.3.0)1、准备工作cuda安装cuDNN安装cuda+cuDNN环境配置python安装2、Tensorflow 安装Anaconda安装1、准备工作首先我们要确定电脑所能支持的tensorflow版本,根据tensorflow官网所给配置,我们要去检查电脑gpu的cuda支持版本,
注意:lib是win64下的内容。
本文介绍了TensorFlow环境的搭建流程:1)推荐安装Miniconda并创建Python3.8环境;2)通过conda/pip安装TensorFlow及相关依赖,建议使用清华源加速;3)重点说明CUDA和cuDNN的两种安装方式(命令行/手动下载);4)完成安装后需验证GPU是否可用。作者强调环境配置过程中可能出现版本冲突问题,需要耐心调试。作为人工智能方向研究生,作者欢迎交流讨论,并祝愿读
硬件踩坑——CUDA版本选择/安装(不同的深度学习项目需要不同CUDA,显卡与cuda匹配问题)
文章目录问题问题cpu版本的tensorflow虽然安装方便,但是运行太慢了,同样是手写识别,gpu可以把cpu5分钟多干完的事情40秒内干完,cpu对急性子太不友好了现在笔记本上大都有独立显卡,而且配置不低,如果不想使用tensorflow时CPU有难,GPU围观,最好还是安装gpu版本吧gpu拉他一起干活...
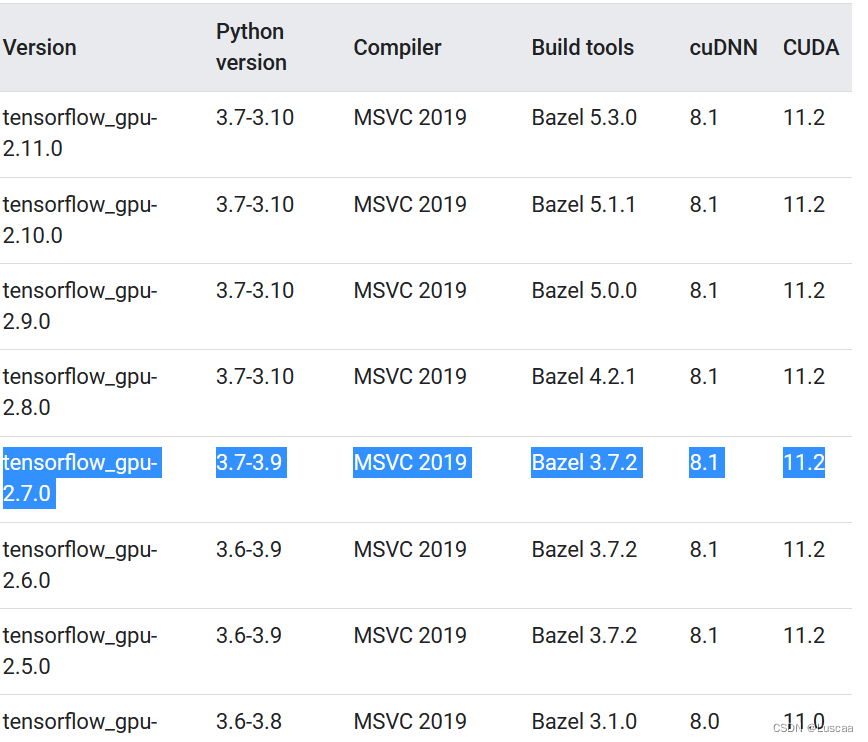
本文是在已有一个版本的 CUDA 11.0 和 cuDNN 10.2(用于Matlab计算加速)的情况下,按照 TensorFlow 的版本要求再安装一个高版本的 CUDA+cuDNN+TensorFlow_gpu_2.7.0+MSVC2019+Anaconda+VScode。本文记录的是安装过程中的作者遇到的问题,对读者有一定的安装经验要求,对完全新手不友好。
点击下面的从源代码构建选择自己的电脑系统后下滑即可查看cpu和gpu的对应版本情况。
docker镜像tensorflow-gpu
sudo nvidia-docker run -p 8888:8888 --name tf1.11_py3 -it -v /home/wang/:/home/wang 0641cda31e80解决了下面问题:>>> import tensorflowTraceback (most recent call last):File "<stdin>", line 1, in
首先是3者以及python的版本关系,如下图如果是用anaconda搭建环境建议在conda的命令行界面(Anaconda Prompt)下载这3个(楼主去官网手动下载CUDA和CUDnn,结果和conda里的环境一直连接不上,各种重装搬运都是血泪史啊)前面两句话是搭房子应该不用说了,后面三句话就是安装cuda、cudnn、tf-gpu最好按顺序来,可能我最开始几次安不上去也有先安装tensorf
ubuntu18.4+rtx3080+驱动-455+cuda11.1+cudnn8.0.4+nvidia-tensorflow==1.15.4最近实验室也给配了rtx3080显卡,但是30系列支持cuda11,tensorflow又没有对应cuda11的版本,通过了解现在还没有适配正式版本,通过阅读别人的博客,自己也尝试了很多,最后能成功调用gpu加速计算的是这个nvidia-tensoeflow
【Win11+RTX3050显卡】cuda+cudnn+tensorflow 环境配置。
因为最近要把cuda10.0升级到cuda11,但是cuda11都不支持tensorflow1.1x版本,所以尝试从源码编译,目前tensorflow官方给出了ubuntu版本的编译方法,nvidia也提供了一款基于ubuntu的nvidia-tensorflow,直接安装在centos上,期间出现了各种问题,因此本文记录了在centos上编译tensorflow-gpu1.15版本的过程,仅供
一、安装anaconda1.首先到官网上下载linux版本的anaconda2.cd到anaconda.sh的目录bash bash ./Anaconda3-5.2.0-Linux-x86_64.sh3.一直按enter,输入yes,选择安装路径,这里选择home下新建的install文件夹/home/superlinc/install/anaconda34.设置将Anaconda...
一、多个cuda版本1、sudo ubuntu-drivers autoinstall 安装驱动,会自带一个cuda,这个cuda是一个版本(通过 nvidia-smi 查看)2、从官网上下载,并安装cuda在/usr/local下,此时又是一个cuda版本(通过 cat /usr/local/cuda/version.txt 查看)1和2两种安装cuda方法,https://blog.csdn.
因为nvidia的升级基本上都是是CUDA12了,在我发表文章的时候如果去官网下载CUDA包默认安装CUDA版本就是12了.解决方法:在安装目录C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v12.2\bin中,把cublas64_12.dll复制一个,名字改成cublas64_11.dll;如果还有其他错误,同样在本目录下面找到对应dll文
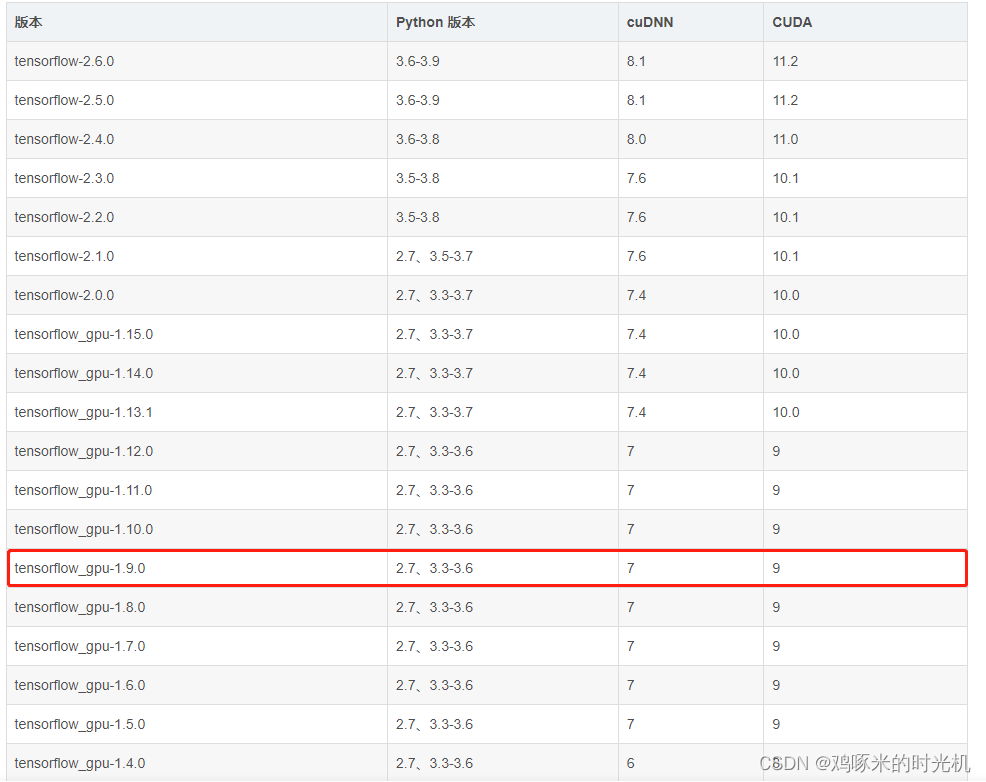
cuda和tensorflow的版本有对应关系https://tensorflow.google.cn/install/source#linux
Could not load dynamic library 'cudart64_101.dll'; dlerror: cudart64_101.dll not found
win10下原安装了py37+tf1.13+cuda10+cudnn7.6,用于tf1框架检测的运算,在C盘系统占空间太大,想移到其他盘,谁知怎么安装都出问题,GPU 不运行,而且训练的模型都保存在C盘昨时文件夹中,也不方便。ubuntu系统安装了anaconda3,py3.8,cuda11.4,470驱动。anaconda可支持多个版本的python,故另建一个py37版本,用于tf1 目标检测
coda12.0的pytorch和tensorflow配置
在尝试使用gpu加速计算时遇到这个问题,在这里做个记录。在安装tensorflow_gpu后,使用代码:print("GPU is", "available" if tf.config.experimental.list_physical_devices("GPU") else "NOT AVAILABLE")检测gpu是否能够参与计算。代码输出为:GPU is available但是在执行先前的
由于本地安装了cuda 10.0, 但是现在需要在Anaconda中安装不同的python虚拟环境来安装tensorflow-gpu、对应的cudatoolkit、对应的cudnn来加速,下面是具体的演示流程。