登录社区云,与社区用户共同成长
邀请您加入社区
【摘要】AI芯片多元化发展带来算力繁荣,但PyTorch框架的碎片化适配问题长期困扰开发者——不同芯片需独立适配,导致代码维护成本高、学习曲线陡峭、迁移效率低下。FlagOS生态推出PyTorch-Plugin-FL解决方案,通过统一接口层兼容异构硬件,结合FlagGems算子库和FlagCX通讯库实现"一次编写,多芯运行",在保证性能的同时大幅降低开发复杂度。该工具将于202
本文介绍了爬取带动态加载验证码网站的完整流程,重点解决数字字母验证码识别难题。通过分析目标网站结构,使用requests.Session保持会话一致性,结合ddddocr工具高效识别验证码。文章详细讲解了从环境配置、网站分析到代码实现的各个环节,包括验证码获取、图像预处理、参数提取等关键步骤,并提供了避坑指南。针对个人学习和中小项目需求,推荐使用开箱即用的ddddocr方案,相比传统OCR识别率可
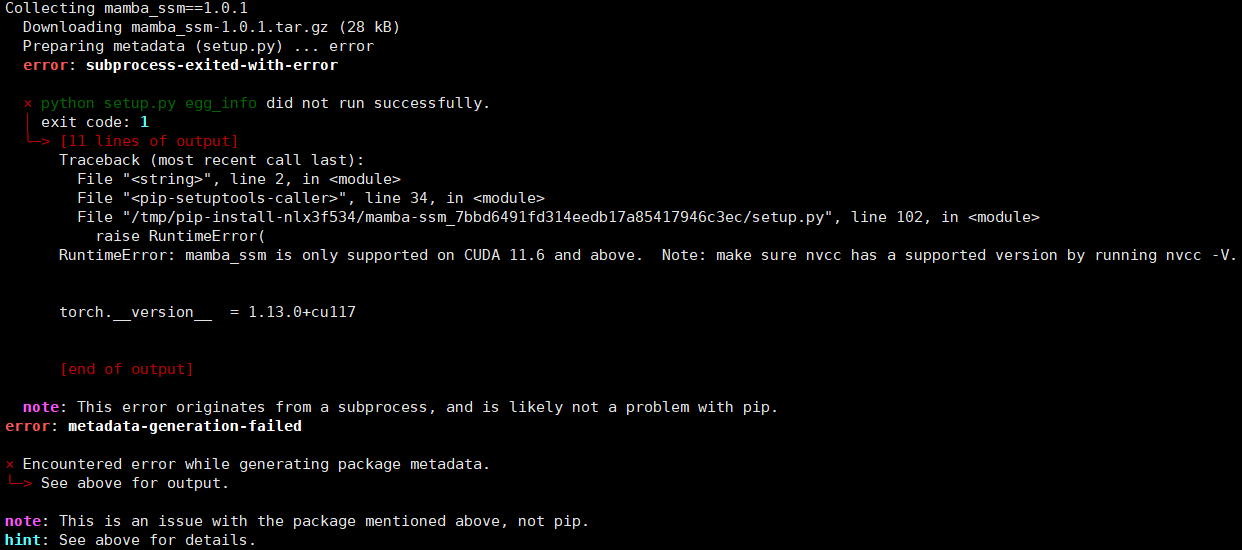
安装mamba_ssm和causal-conv1d报错 python setup.py egg_info did not run successfully和RuntimeError: mamba_ssm is only supported on CUDA 11.6 and above错误解决
在网上查了可能的原因,①CUDA版本与驱动程序不兼容;②CUDA库的路径设置存在问题;③PyTorch版本与CUDA版本不匹配;我的解决办法是,重新安装了torch,解决了这个问题。显然没有缺失的包和版本冲突,所以故障原因不明。希望得到大佬的解答~之前一直没有这种问题,重装了anaconda以后出现了这种问题。不过这些和我的情况都不太符合。
服务器上安装tinycudann,一次成功
查看虚拟环境内的cuda、cudnn版本。
光流的定义之类的,大家如果不了解可以自行搜索,这里就不讲了。要进行光流提取,有很多传统的方法,不一定要用深度学习,例如用opencv里面自带的方法也可以做。这里说一说flownet这个网络 目前看有v1 v2 v3了 原作者的github一直在更新也给了docker版本,奈何我这里配置docker的images就用不了,因此在网上找到了一个pytorch的实现。这里把实现过程分享给各位。第...
通过python文件在gpu上运行代码流程,要想用gpu必须要有适合gpu的驱动cuda driver以及对应cuda版本的torch、torchvision等库。把三个文件夹复制到cuda安装地址(默认C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA),覆盖原有文件夹。向下兼容,安装
因为cuda具有高效利用GPU进行科学计算的优势,而人工智能的重点之一就是复杂的计算任务,因此学好GPU计算是学习AI的重点任务。这里,我们即将进行利用共享内存的矩阵运算。我们看一个例子,如何对矩阵进行分配显卡内存以及元素赋值操作。通常来讲,在GPU中分配内存使用的是cudaMal...
打开Anaconda Prompt命令行创建虚拟环境命令如下:查看已经创建的所有虚拟环境:conda env list创建新虚拟环境: conda create -n test python=3.7 #-n 后面加虚拟环境名称,指定python的版本启动虚拟环境:conda activate test此时,虚拟环境已经创建完成,接下来在虚拟环境中安装pytorch。!!!pytorch安装很容易出
window下安装了不同版本的cuda,不会将之前的cuda文件覆盖。而是以不同的文件夹保存在C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA目录下。查看当前cuda版本nvcc -Vcuda版本为10.1切换cuda右键此电脑 -> 属性 -> 高级系统设置 ->环境变量双击path将需要切换版本的两个路径移动到最上面C:\P
Could not load dynamic library ‘cudart64_100.dll’; dlerror: cudart64_100.dll not found;cublas6_100.dll not found;cufft64_100.dll not found;curand64_100.dll not found;cusolver64_100.dll not found;cuspa
Python崛起并且风靡,因为优点多、应用领域广、被大牛们认可。学习 Python 门槛很低,但它的晋级路线很多,通过它你能进入机器学习、数据挖掘、大数据,CS等更加高级的领域。Python可以做网络应用,可以做科学计算,数据分析,可以做网络爬虫,可以做机器学习、自然语言处理、可以写游戏、可以做桌面应用…Python可以做的很多,你需要学好基础,再选择明确的方向。这里给大家分享一份全套的 Pyth
之前用别人的一键包(confyui加各种东西),现在需要用到别的python版本,发现自己弄完的xformers又有问题,因为有些东西便携包都安装好了果真就是得自己搞一遍才会懂老规矩:available不就是正常的缺少依赖库嘛,还以为很简单的pip install,没想到不行.....而且基本都是liunx的,window版本还是得用大佬的,不然就得自己去编译,而且据说强行在window上面编译的
【代码】cuda11.2安装pytorch。
难道他真的是装环境的天才(双系统ubuntu24.04+cuda+pytorch+cudnn安装)
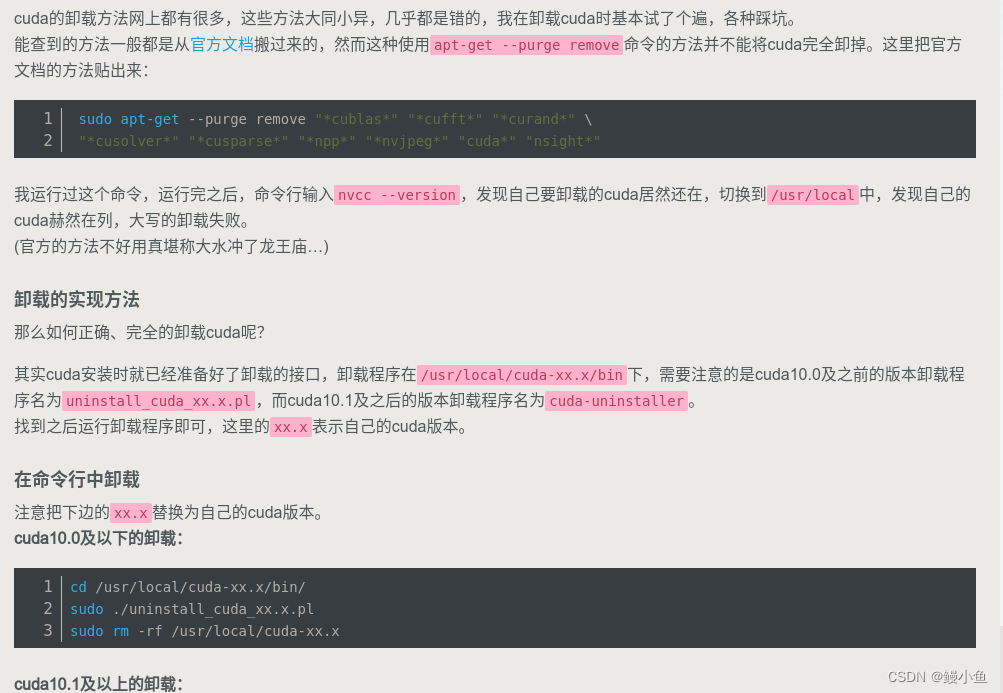
我们都知道,cuda的一般卸载需要依次选中需要卸载的CUDA包,鼠标右键点击卸载即可,一般需要保留3个已经安装的CUDA包,分别为NVIDIA GeForce Experience x.x.x.x、NVIDIA PhysX 系统软件 x.x.x、NVIDIA 图形驱动程序 x.x。因为cudnn文件还在的缘故,自己的cuda-xx.x文件夹仍然在,需要手动删除。我想大家都会有这个疑问,同样,我也是
?
要判断计算机是否安装了 CUDA,可以在命令行/终端中运行以下命令:nvcc -V如果已经安装了 CUDA,则会显示 CUDA 版本信息;如果没有安装,则会出现「command not found」的错误信息。此外,还可以通过检查系统的「设备管理器」或「控制面板」中的「显卡」部分,来确认是否安装了 CUDA 驱动程序。...
首先出现这个报错说明在/usr/local/cuda-11.5/lib64目录中确实没有libcudart.so.10.2这个文件,然后按照网上的。首先查看系统内核,选择需要的CUDA版本,通过命令。安装好了cuda 10.2后,运行代码又报错了。,然后再安装就提示安装失败),结果又报错。是什么意思,后面搜了下。指的应该是gcc版本(
编译安装MinkowskiEngine
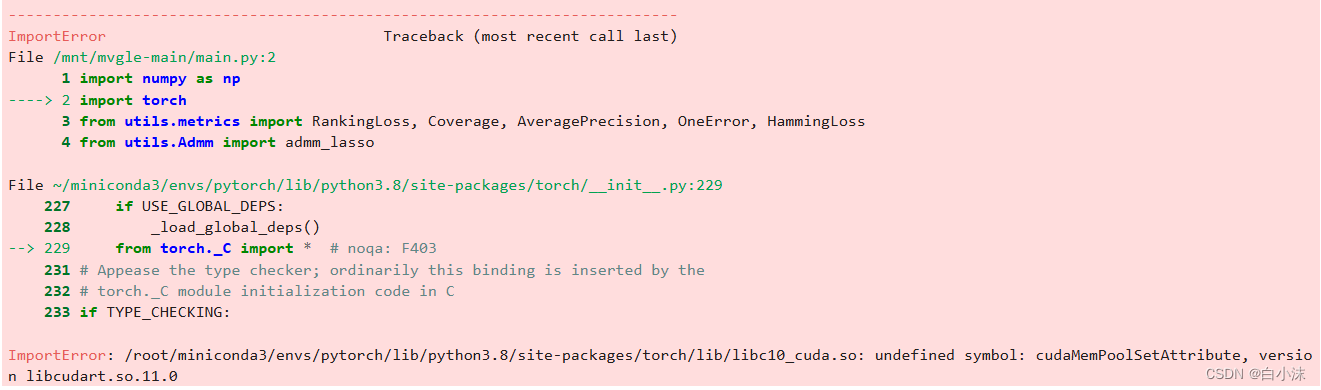
“ImportError: /root/miniconda3/envs/pytorch/lib/python3.8/site-packages/torch/lib/libc10 cuda.so: undefined symbol: cudaMempoolsetAttribute, version libcudart.so.11.0”
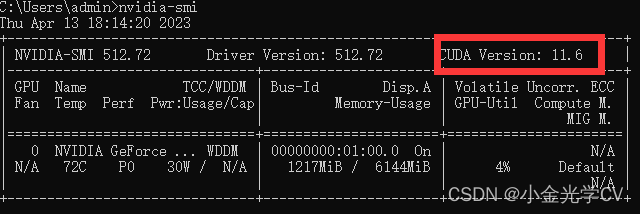
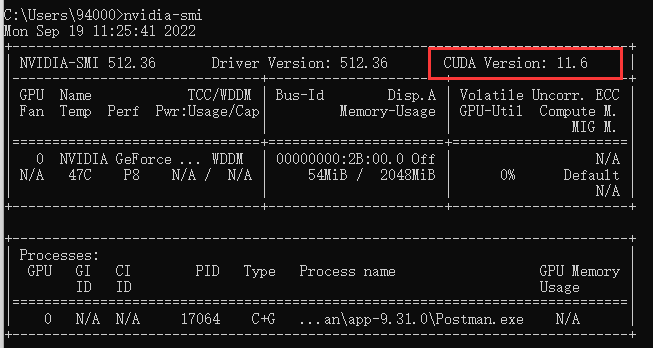
前言运行之前运行没有报错过的基于tf1.13.1的程序,报错:CUDA driver version is insufficient for CUDA runtime version网上搜索了一下,是因为cuda的驱动版本与cuda的运行版本不匹配导致的。后面询问,原来是组里其他人在全局进行了操作,导致此项问题出现。关于cuda驱动版本与运行版本在命令行中输入:nvidia-smi,在右上角会出现
autodl容器里安装cuda和cudnn以及下载mamda模型
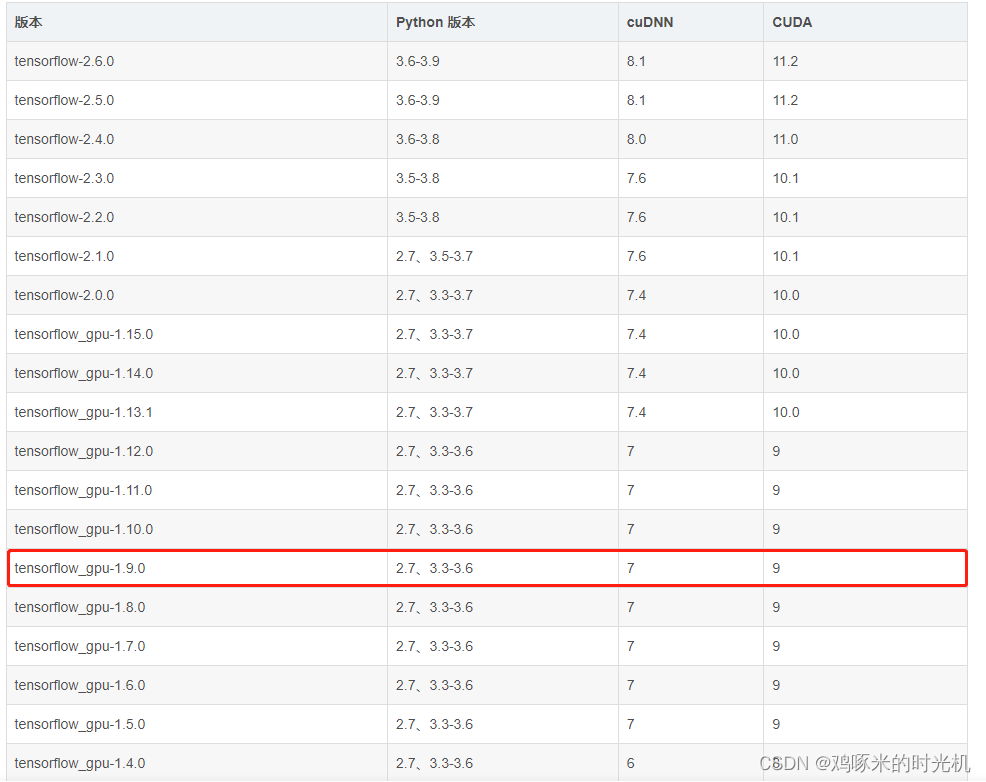
可以看到需要对应安装cudatoolkit==9.0, 我们在通过命令: “conda search cudatoolkit"来看一下是否有此cudatoolkit的安装包,输入"conda search cudatoolkit”安装成功cudatoolkit之后,需要再安装对应版本的cudnn, 于是通过conda search cudnn查看一下,发现也是有可以安装的版本。发现是有这个cuda
总结:torch GPU环境的安装主要是cuda版本和torch版本的对应,然后就是下载torch比较麻烦,大家在安装的过程中有任何问题都可以私信找我,我这边看到会尽可能帮大家解决。(4)下载的过程中可能会出现下载失败或者下载异常的问题,如果通过以上命令安装失败的话,我这边给大家准备了下载好的轮子,大家可以自行下载并安装。(2)我个人下载的是11.3的版本,两个都可以,如果是11.3的版本可以用如
linux 查看cuda、cudnn版本。以及推理变慢等原因的排查。
在anaconda3的目录下搜索cudart64_100.dll,把它的路径加入到系统环境变量PATH中,重启kernel,再次运行代码,就没有报错了。参考链接:https://www.lagou.com/lgeduarticle/74076.html
最近一年多时间里,陆续安装了几块4090显卡。在不同的机器上下载CUDA驱动时,有时选择了11.8版本,大多数时候选择的是12.x的版本。平时开发大部分时间使用pytorch,偶而使用tensorflow。每次安装Tensorflow时都需要折腾很长时间。出现的问题要不是上面找不到某些cudart64_110.dll的错误,要不其它的一些问题。在Win11和WSL2上都存在问题。
pycharm安装pytorch(无需cuda)
安装pykeops库后报错:
注:会提示找不到gcc与g++,这里按照提示安装默认gcc和g++即可,要求gcc和g++版本匹配,均为11.4.0。5.打开“软件和更新”,选择“附加驱动”为:nvidia-driver-535(专有,tested)(这是下载cuda12.1安装包,推荐在bash环境中下载)4.安装相对应pytorch,cuda 12.1版本。(这是在虚拟环境中安装cuda命令)3.安装cuda12.1.0版本
运行pytorch在计算cross_entropy的loss遇到报错RuntimeError: "nll_loss_forward_reduce_cuda_kernel_2d_index" not implemented for 'Int'`原因是pytorch自带的损失计算函数不支持原本的标签1,2,3,4…,n,需要转换成网络需要的one_hot编码才行具体代码如下one_hot = torc
联想拯救者Y7000P显卡:英伟达4060 系统:Win11。