登录社区云,与社区用户共同成长
邀请您加入社区
FlagOS社区同步完成智谱开源多模态MoEt模型GLM-5.3-Flash在9款芯片的Day0适配,当前模型镜像已发布魔搭和Hugging Face,开发者无需修改代码即可跨芯部署!
FlagOS 为主流推理框架打造了统一的多芯片插件,包括 vLLM-plugin-FL 和 SGLang-plugin-FL,基于 FlagOS 统一多芯片后端开发,在不改变原生接口与用户使用习惯的前提下,实现 Qwen3.8-Flash-Next 的多芯片推理部署。其他芯片的运行时版本、插件分支、FlagGems/FlagTree 提交以及是否需要 FlagCX,请以对应芯片的模型卡和 vLLM
视频生成推理框架 LightX2V 近日推出基于 FlagOS 的跨芯片插件 lightx2v-plugin-FL。该插件以独立 Python 包形式接入,不改主链路,即可为 LightX2V 获得跨芯片适配能力。目前已在平头哥 PPU-ZW810E 双卡上完成 DreamZero 视频与动作生成任务的完整链路验证。
联合国开发计划署非洲区域局将于9月1日在北京智源人工智能研究院举办“廷巴克图”中非AI合作研讨会。会议聚焦非洲初创企业在医疗、金融、农业等领域的AI应用需求,探讨中非在技术、算力、投资等方面的合作路径。五家非洲创新企业将展示本土化解决方案,中方将分享FlagOS开源技术等成果,旨在通过开放计算生态降低算力门槛,推动AI普惠发展。活动以闭门交流形式促进务实对接,助力中非数字合作从理念走向落地。
字节跳动8月连续推出两大技术突破:特斯拉中国车机集成豆包大模型,以及Seedance2.5实现电影级数字人动作迁移。其核心在于强化学习后训练(RL Post-Training)技术的突破,而非单纯参数堆砌。为解决多元AI芯片适配难题,FlagOS团队推出verl-hardware-plugin多芯片插件平台,提供六大芯片参考实现,实现“字节框架+社区插件+多元芯片”的协同模式。
FlagOS开放计算全球大赛第二赛季正式启动,聚焦AI芯片算子优化难题。赛道一围绕SGLang框架算子性能优化,设置200+真实推理场景赛题,采用游戏化“高地争夺”机制,开发者需通过Triton语言实现跨芯片高性能算子。比赛设置三大奖项,优胜代码将开源并应用于实际生产。赛事面向全球开发者开放团队报名,通过多芯片统一评测选拔优秀方案,旨在推动大模型推理技术的产业化落地。
阿里巴巴开源270亿参数视觉语言模型Qwen3.8-27B,并通过众智FlagOS社区完成跨平台适配。该模型已在11款AI芯片(包括平头哥、英伟达、摩尔线程等)和ARM端侧平台完成部署验证,其中摩尔线程支持FP8精度,其余芯片支持BF16。FlagOS技术栈首次实现27B大模型在ARM平台的W4A8低比特量化部署,推理性能显著优于原生方案。模型具备26万token长文本处理能力,支持代码生成、智能
阿里巴巴开源超大规模MoE模型Qwen3.8-2.4T-A95B,该模型总参数达2.4万亿,激活参数95B,是当前开源规模最大、能力最强的模型之一。众智FlagOS社区同步完成该模型在平头哥、英伟达等9家AI芯片上的Day0多芯适配,提供BF16、FP8、INT8等多种精度版本。FlagOS通过统一技术栈实现一次开发、多芯快速适配,已累计完成12款主流开源模型在10款芯片上的跨芯适配。Qwen3.
【摘要】AI芯片多元化发展带来算力繁荣,但PyTorch框架的碎片化适配问题长期困扰开发者——不同芯片需独立适配,导致代码维护成本高、学习曲线陡峭、迁移效率低下。FlagOS生态推出PyTorch-Plugin-FL解决方案,通过统一接口层兼容异构硬件,结合FlagGems算子库和FlagCX通讯库实现"一次编写,多芯运行",在保证性能的同时大幅降低开发复杂度。该工具将于202
【摘要】北京智源AI研究院联合多所高校及开源组织发起OASIS-AI国际研讨会,将于2026年11月1日在希腊雅典MICRO2026会议期间举办。会议聚焦异构AI系统的开放软件生态建设,重点探讨新型AI芯片架构、开源编译器优化、大模型部署等关键技术,特别关注FlagOS开源社区的多芯片适配实践。现公开征集研究论文(6页)、进展报告(4页)及系统演示(2页)三类投稿,截稿日期为2026年8月31日。
FlagOS团队在FlagTree组件中开发了一套统一的设备侧Profiler&Debugger工具,旨在解决AI算子开发中的性能调优和数值bug排查难题。该工具突破传统调试局限,提供细粒度Kernel耗时分析(精确到内部操作)和全流程数值追踪能力,并设计抽象层适配不同芯片厂商接口。直播将分享工具架构设计、核心功能演示(8月6日19:00),展示如何实现算子开发从"盲调"到"可观测"的转变。该方案
2026年8月4-8日,北京智源人工智能研究院等机构将联合举办全国高校人工智能自主软硬件知识公益研修班。研修班面向高校教师,依托FlagOS在线实验平台开展线下实操培训,聚焦AI系统软件与异构计算五大核心模块,通过“讲授+实操”模式助力AI教学升级。这是继2026年4月成功实施“中非人工智能人才培养计划”后,FlagOS社区将国际验证的“种子教师”培育模式引入国内的实践。FlagOS2.1开源技术
本文对比了FlashKDA与Triton-TLE在处理线性注意力机制时的性能优化方案。FlashKDA通过将计算拆分为并行准备阶段(K1)和顺序递推阶段(K2),实现了每16个token一次的状态依赖处理。Triton-TLE在此基础上进一步优化:K1阶段利用显式共享内存和异步加载减少线程等待;K2阶段将FP32主状态保留在寄存器中,减少数据搬运。在H800配置测试中,该方案获得了1.38倍的几何
随着AI大模型加速上车,2026年车载智能体将迎来爆发,但芯片适配成本高、周期长成为行业痛点。智能汽车多芯片异构架构导致底层软件需重复适配,而车载芯片代际更迭(算力跃升至千TOPS、供应商多元化)进一步加剧挑战。FlagOS开源系统提出解决方案,通过统一软件栈实现"一次开发、多芯部署",助力车企摆脱单一生态绑定。7月31日上海将举办行业研讨会,集结车企、芯片商、软件公司共议AI基础软件生态建设,推
7月19日,WAIC 2026 · AI 开放计算与智能体技术生态论坛在上海落下帷幕。站在智能体时代的门槛上,来自全球多个机构的产学研领袖在论坛上共同发出一个重要声音:以“众智FlagOS”为基础的人工智能开放计算技术栈逐渐成型,智算共享生态正在形成;以众智FlagOS、PyTorch、HuggingFace、Eclipse基金会等开源平台组成的全球人工智能开源力量有望成为全球AI普惠的重要技术基
作者 | CSDN 编辑部出品丨AI 科技大本营(ID:rgznai100)算力已成为 AI 时代的“石油”,但如何高效挖掘异构算力的潜能,打破单一硬件架构的软件壁垒,是全行业面临的共同考题。过去二十年,CUDA 几乎定义了 GPU 编程的主流路径。但在 2026 年,随着更多国内 AI 芯片算力崛起与异构计算的普及,Triton 正从一个学术界的编程语言,演变为工业界打破 CUDA 垄断、连接上
笔者这几天需要使用Google的mediapipe框架进行自定义的数据训练,值得注意到的是Google家的这个方便的自定义训练只支持在Linux下完成。具体原因可以参考到也即是google.colab库需要的环境就是Unix系的OS。。。所以没办法(耸肩),只好在WSL上完成mediapipe应用框架的搭建,刚好笔者准备尝鲜。
在网上查了可能的原因,①CUDA版本与驱动程序不兼容;②CUDA库的路径设置存在问题;③PyTorch版本与CUDA版本不匹配;我的解决办法是,重新安装了torch,解决了这个问题。显然没有缺失的包和版本冲突,所以故障原因不明。希望得到大佬的解答~之前一直没有这种问题,重装了anaconda以后出现了这种问题。不过这些和我的情况都不太符合。
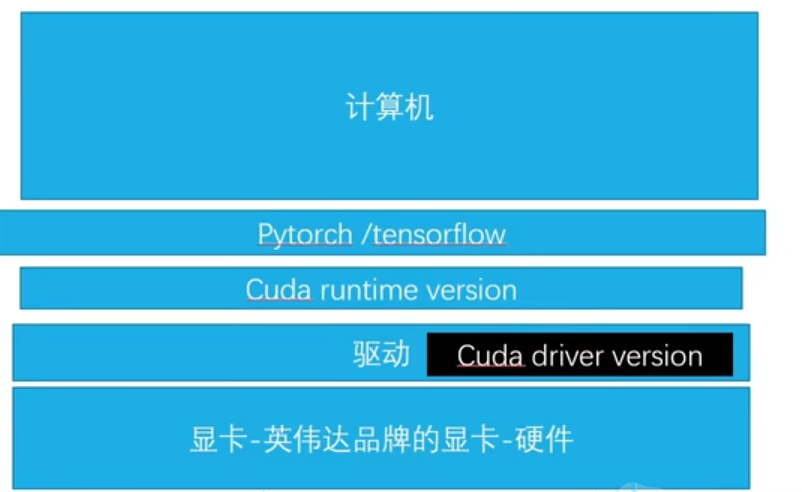
通过python文件在gpu上运行代码流程,要想用gpu必须要有适合gpu的驱动cuda driver以及对应cuda版本的torch、torchvision等库。把三个文件夹复制到cuda安装地址(默认C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA),覆盖原有文件夹。向下兼容,安装
1.查看cuda版本win+R+enter回车,再输入cmd进入命令行,再输入nvcc --version或者输入nvcc -V即可得到cuda的版本,如图我的cuda版本是10.2查看cudnn版本进入目录查看cudnn_version.h文件一般放在:C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v10.2\include\cudnn_v
难道他真的是装环境的天才(双系统ubuntu24.04+cuda+pytorch+cudnn安装)
要求请参考下表,了解ONNX运行时推断包的官方GPU包依赖关系。请注意,ONNX运行时训练与PyTorch CUDA版本保持一致;有关支持的版本,请参阅onnxruntime.ai上的“优化训练”选项卡。由于Nvidia CUDA次要版本兼容性,使用CUDA 11.8构建的ONNX Runtime与任何CUDA 11.x版本兼容;使用CUDA 12.x构建的ONNX Runtime与任何CUDA
在scaler.scale(loss).backward()前添加torch.use_deterministic_algorithms(False)根据报错提示,找到train.py文件中的317行。
我们都知道,cuda的一般卸载需要依次选中需要卸载的CUDA包,鼠标右键点击卸载即可,一般需要保留3个已经安装的CUDA包,分别为NVIDIA GeForce Experience x.x.x.x、NVIDIA PhysX 系统软件 x.x.x、NVIDIA 图形驱动程序 x.x。因为cudnn文件还在的缘故,自己的cuda-xx.x文件夹仍然在,需要手动删除。我想大家都会有这个疑问,同样,我也是
显卡为3060ti g6x,操作系统win10。
?
opencv | cv::cuda::GpuMat upload函数用法
要判断计算机是否安装了 CUDA,可以在命令行/终端中运行以下命令:nvcc -V如果已经安装了 CUDA,则会显示 CUDA 版本信息;如果没有安装,则会出现「command not found」的错误信息。此外,还可以通过检查系统的「设备管理器」或「控制面板」中的「显卡」部分,来确认是否安装了 CUDA 驱动程序。...
或者dpkg -l | grep cudnn。查看tensorrt版本:dpkg -l | grep TensorRT。查看cuda版本:`nvcc` --version,nvcc -V。
造孽的时间又来了,我真的什么都不知道
autodl容器里安装cuda和cudnn以及下载mamda模型
在Ubuntu的conda虚拟环境中安装transformer-engine时出现CMake错误,主要原因是未正确配置CUDNN路径。解决方案是:首先确认已安装cudnn(可通过pip list查看),然后设置环境变量CUDNN_PATH和CPLUS_INCLUDE_PATH,指向cudnn的安装路径(通常在conda环境目录下的nvidia/cudnn中)。具体步骤参考GitHub issue
│ └── model.onnx(存放模型或者源文件)├── config.pbtxt(模型配置文件)├── densenet_labels.txt(标签文件,对于分类模型可自动转换结果到标签)
windows使用linux教程。wsl子系统的安装。可调用宿主机显卡支持cuda。
联想拯救者Y7000P显卡:英伟达4060 系统:Win11。
2.检查CUDA版本是否兼容,使用nvidia-smi查看显卡目前能支持的CUDA版本,确保安装的pytorch对应CUDA版本<=显卡目前能支持的CUDA版本.1.确保显卡驱动是否正确安装,运行。,如果正常输出,则没问题。